Cache Memory and Pipelining
- Cache分层分为L1,L2缓存,当L1 miss时就会查L2,L2 miss时再访问主存
- Cache通常使用Static RAM(访问速度快,不需要周期性refresh)而Main memory通常使用Dynamic RAM(访问速度较慢,需要周期性refresh)
- cache memory的表现通常使用hit ratio(HR)和effective access time(EAT)衡量:
HR=Total No. of memory accessesNo. of hits
EAT=Total No. of memory accesses(No. of hits)×Th+(No. of misses)×Tm
- 其中 Th 和 Tm 分别是命中(hit)与未命中(miss)时的访问时间
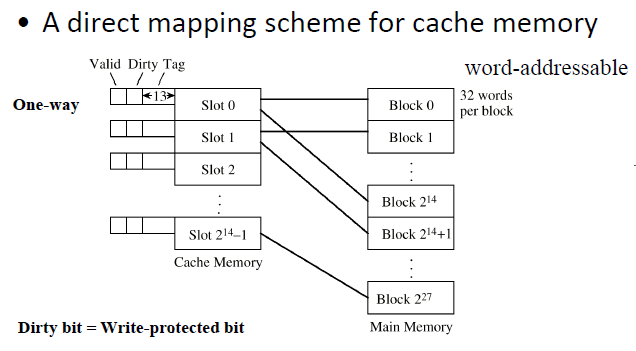
Direct mapping scheme
Pipelining
- 一条指令的执行可以划分为若干阶段,最基础的划分是三个阶段:
- F(fetch):取指令
- D(decode):解码指令
- E(execute):执行指令
- Pipelining(流水线)让多条指令的不同阶段在时间上重叠执行,从而提高整体吞吐量
pipelining and non pipelining
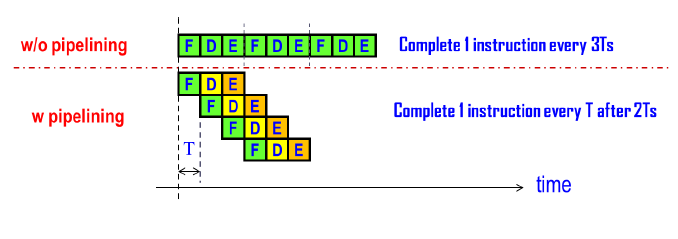
- Ts: 串行执行(non-pipelining)完成整个过程所需的时间
- Tp: 流水线执行(pipelining)完成整个过程所需的时间
- T1,T2,T3代表各个独立阶段所需要的时间
- 理想情况下, Tp = N * Tg, 其中N为流水线级数,Tg为单级处理时间等于max(T1,T2,T3)(理想情况下T1=T2=T3)
- 理想情况下,流水线执行的最大理论加速比等于流水线级数 N:
S=TpTs=(N+n−1)⋅Tgn⋅N⋅Tgn→∞N
Pipelining Problem
Software Interrupts
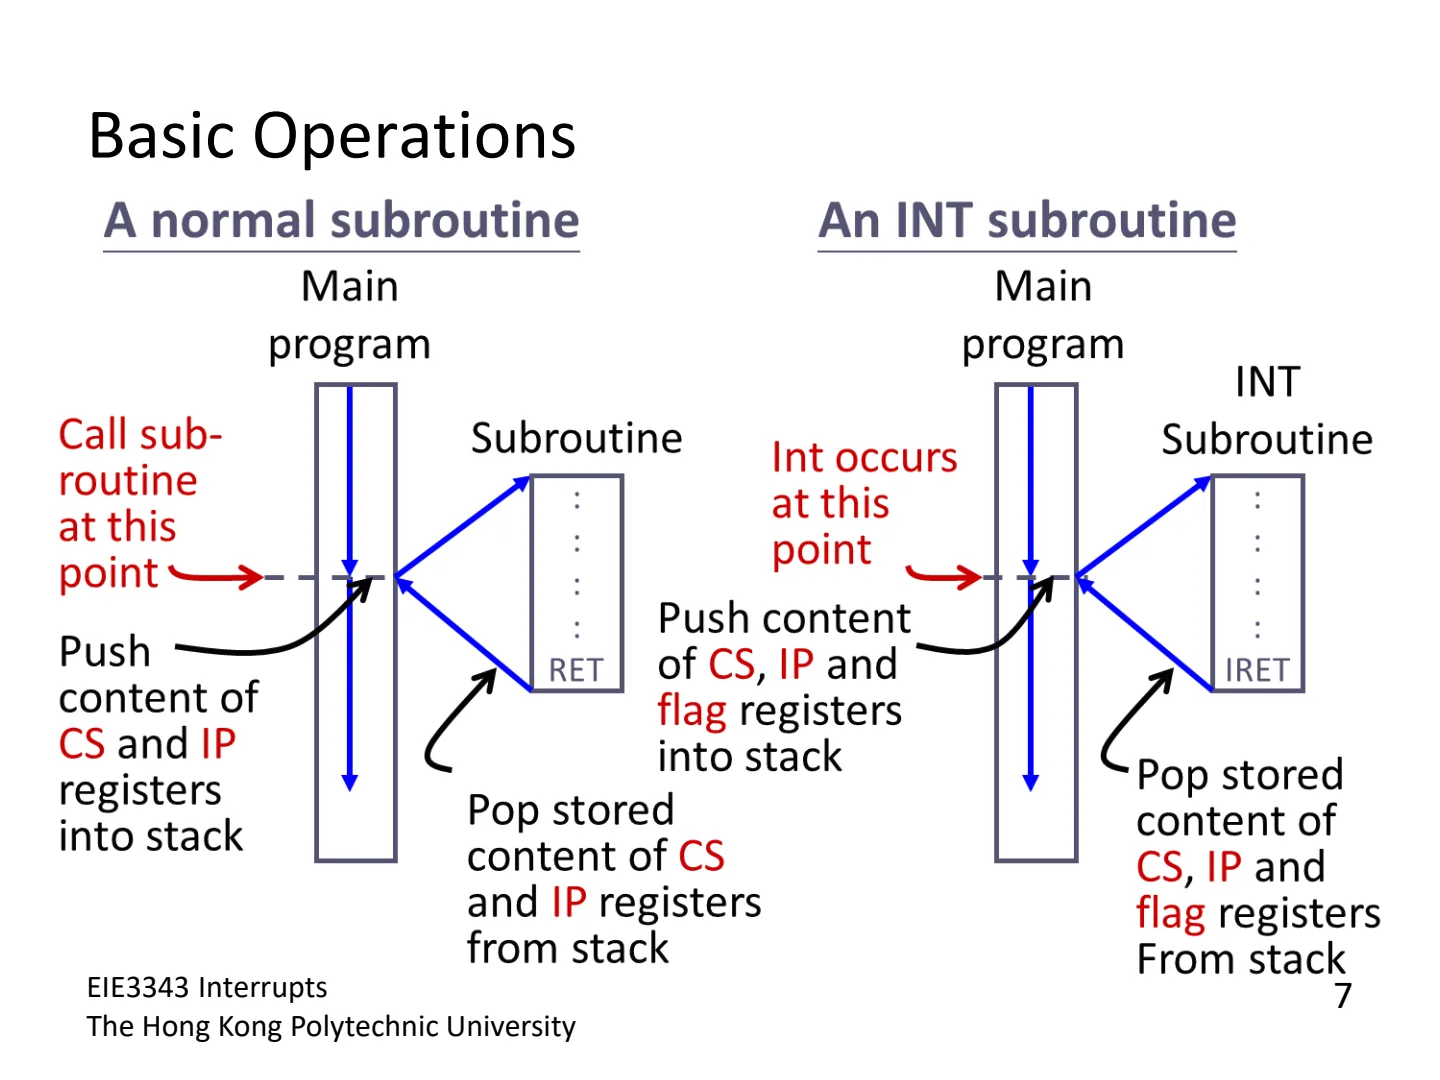
Basic operations
- normal subroutine由主程序主动调用,将
CS和IP压入栈进行保护,并使用RET(return)进行返回
- 而INT subroutine通过Int触发,将
CS,IP和flag寄存器全部压入栈中保护,使用IRET(Interrupt RET)恢复并返回
Hardware pin
- INTR: Interrupt request,外部设备用它提出请求,可屏蔽
- NMI: Non maskable iterrupt,不可屏蔽,边缘触发
- INTA:Interrupt acknowledge,CPU对INTR的应答
Interrupt Vector table
- 用于指向应对不同type的interrupt对应的代码位置,传回ISR在内存中的真实起始地址
- 在real mode下,每个interrupt vector占用4 bytes, 其physical address(目录地址) = interrupt number * 4(等于实际interrupt程序的offset), 再加上段地址就得到了实际程序的physical address
Non - preemptive
- one interrupt can not disturb other interrupt
c programs
interrupt flag Bits
- cli(): clear interrupt flag
- sti(): set interrupt flag
operation
Hardware interrupts
NMI
- 硬件层面表现为在上升沿的电平跳变信号(edged-triggered)
- 常用于parity errors和其他主要的系统错误(如电源故障)
INTR and INTA
- INTR - interrupt request,表现为level triggered
- INTA - interrupt acknowledge
-
- timing diagram(hardware) 类比 function prototype(software)
- timing diagram能够表示在第几个时钟周期给哪个引脚发电平信号能得到什么结果
链接