SparkSQL
Chanllenges with Spark
- Spark的核心API建立在RDD这一底层抽象上,要求开发者自己定义transformation和action
- RDD API也允许开发者将任意函数传给transformation,这些函数被当作黑盒处理
- 因此引擎对于操作语义的可见性有限,限制了优化器生成高效的执行计划
- 储存的通用对象是任意的Java/Python对象,对象本身往往比其中的数据要大好几倍
Dateframe and RDD
- Spark+RDD: 使用RDD对不透明对象的partitioned collection做函数式transformation
- SQL+Dataframes(SchemaRDDs): 对tuples的partitioned collections做声明式transformations
SparkSQL Architecture
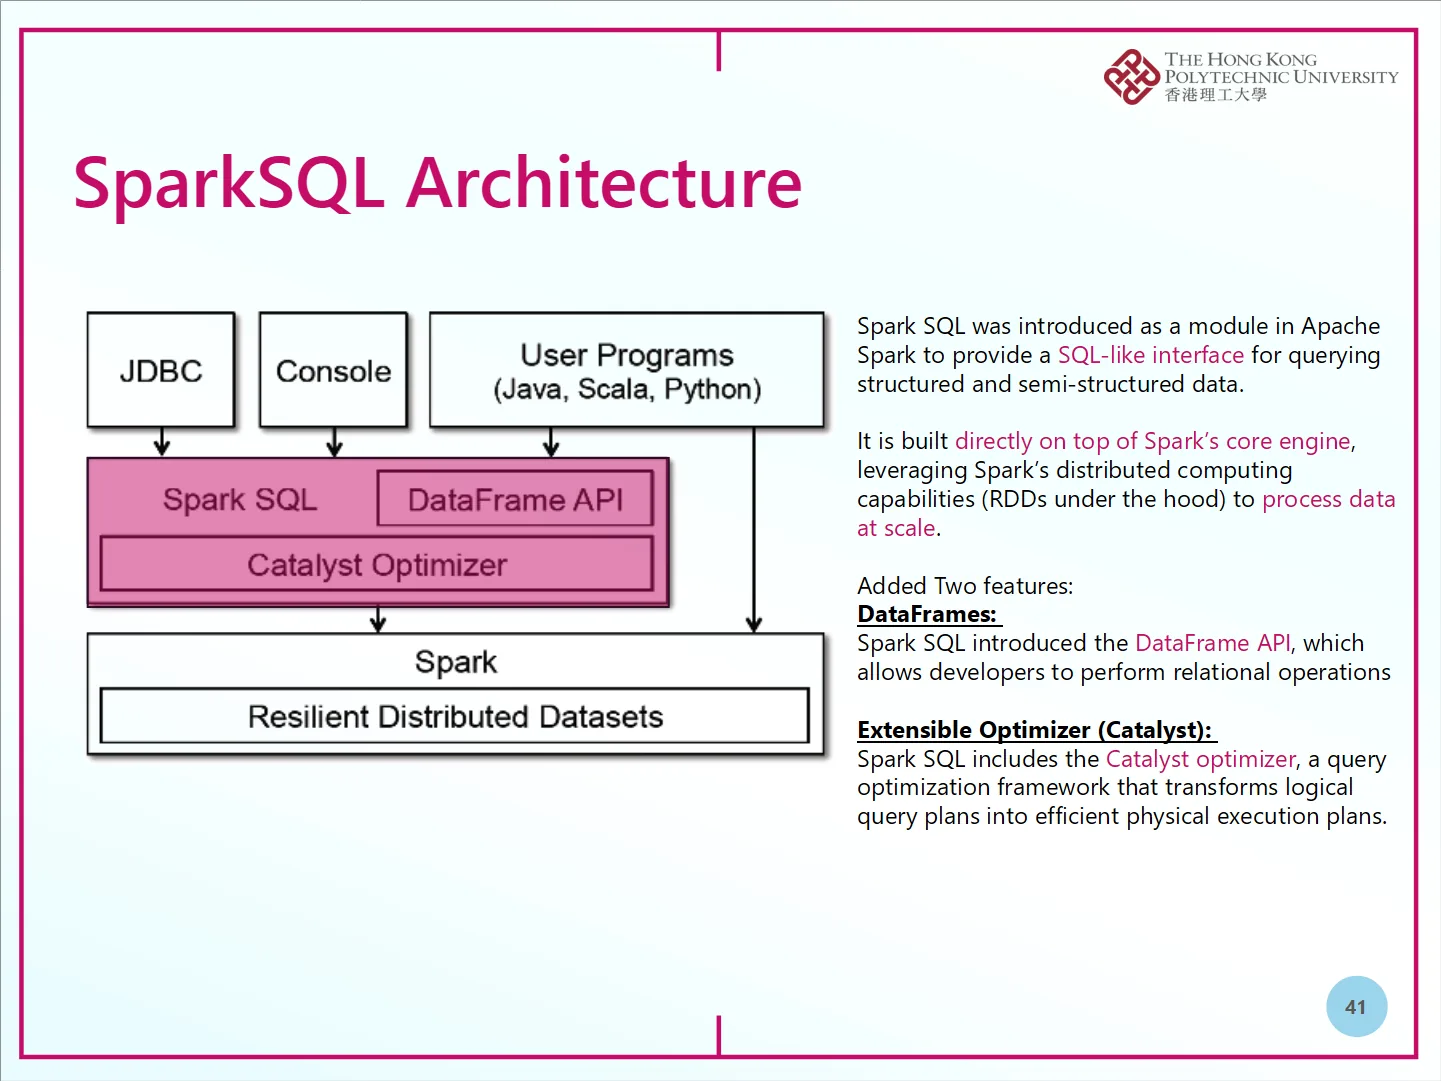
- SparkSQL作为Apache Spark中的一个模块引入,用于提供类SQL的接口,直接构建在Spark核心引擎之上,借Spark的分布式计算能力来处理大规模数据
- 新增了DataFrame和Catalyst(可扩展优化器)
DataFrame
- 按照named columns组织起来的dataset,在概念上等价于relational database中的table
- 在Spark中。Dataframe是惰性的,每个Dataframe对象代表一个用于计算数据集的逻辑计划(计算过程), 在output operation之前不会产生执行
Dataframe vs RDD
- RDD: 使用Python/Java/Scala Transformation(map/reduce)交给JVM后端执行
- SparkSQL: DataFrame API或者SQL query先转化为Logical plan,经过Catalyst改写产出Physical plan执行
Dataframe advantage
- optimization execution: schema信息使得优化成为可能
- built-in optimization: 使用catalyst优化器进一步优化,包括predictive pushdowns/constant folding/loop unrolling等solution进行自动优化,相较RDD执行效率更高
- compact binary representation: 使用列式存储,optimization across operators(跨算子优化)
- easy of use: 提供high-level, 类SQL的接口与数据交互, 比复杂的RDD变换更简化
- integrated with the rest of spark: 集成在Spark中接入Spark生态
- interoperability: 可以方便的与其他数据格式互转
Dataframe operations
- 支持所有常见的relational operators: projection(select), filter(where), join, groupBy
- example
employees.join(dept, employees.deptId == dept.id)   # Join condition
    .where(employees.gender == "female")            # Filter condition
    .groupBy(dept.id, dept.name)                    # Group by
    .agg(count("name").alias("employee_count"))
- 通过AST(sbstract syntax tree)组合算子,而不是立即触发计算
Dataframe creation
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("Create-Dataframe")
csv_file_path = "./data/products.csv"
df = spark.read.csv(csv_file_path, header=True)
df.printSchema()    #display schema of dataframe
df.show(5)    #display content of dataframe
df.columns()    #display columns
Select
# Select specific columns
selected_columns = df.select("id", "name", "price")
print("Selected Columns:")
selected_columns.show(10)
Filter
#Filter rows based on a condition
filtered_data = df.filter(df.quantity>20)
print("Filtered Data: ",filtered_data.count())
filtered_data.show()
GroupBy and Aggregations
# GroupBy and Aggregations
grouped_data = df.groupBy("category").agg({"quantity": "sum", "price": "avg"})
print("Grouped and Aggregated Data:")
grouped_data.show()
toDF
- 根据已有的Dataframe创建新的Dataframe
- 此处取
name和price两列改名为pname和price of product再显示前五行
df.select('name','price').toDF('pname','price of product').show(5)
Join
# Join with another DataFrame
df2 = df.select("id", "category").limit(10)
joined_data = df.join(df2, "id", "inner")
print("Joined Data:")
joined_data.show()
Alias
Map
map()
flagmap()
mergge columns
链接