Introduction to Spark
Intro to MapReduce
Traditional and Parallelize
- 传统数据处理使用串行处理, 速度较慢, 不能充分利用算力
- Parallelized System(并行系统)通过Partitions(切分)->Workers(并行处理)->Combine(汇总), 其中Workers可以拆分成三种粒度:
- distinct server in different locations(异地独立服务器)
- local machine(本地机器)
- CPU core in a machine(一台机器中的单个CPU核)
MapReduce
- MapReduce是第一个被广泛采用的distributed big data processing(分布式大数据处理)框架
- 关键优势:
- 简化的编程模型: map & reduce
- 在廉价硬件上表现出的强大scalability
- built-in的容错能力
- 解决了阅读海量数据的问题:
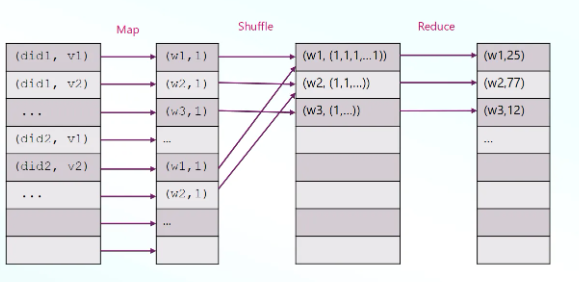
- Map: 从每条数据/每篇文档中抽取信息
- Shuffle and Sort: 在不同的机器之间shuffle同时交换数据和文档
- Reduce: aggregate(聚合), summarize(汇总), filter(过滤), transform(变换)
- Write得到最终结果, 在此过程中保持paradigm不变并且只修改map和reduce函数即可适配不同问题
Data Model
- 在HDFS中,假设文件都以扁平形式存在(表示为无顺序的键对)
- Map reduce program会接收这样的无顺序键对(key,value)并输出处理后的无顺序键对(key,value)
MapReduce Issues/Challenge
- 在Map Reduce中存在以下问题:
- 任何任务都必须拆解成Map和Reduce, 表达力受限
- 为了容错,Map得到的结果必须先写进HDFS
- 每次迭代必须以磁盘为总线,速度很慢
- 同样为了容错,每份数据还必须在磁盘上保留replication,慢上加慢
- 理想情况下, 数据操作应当基于内存进行而不是磁盘
- 直接将内存作为总线也不可行,因为这套为磁盘设计的容错在内存上运行过于昂贵(整体读写),因此必须放弃细颗粒度的操作(精准修改)转而变为粗颗粒度(整体修改, 如filter)
- 最终就会得到RDD
Intro to Spark
- spark是一个用于并行数据处理的managing framework
- 支持大规模数据处理
- 把数据存放在内存/本机
- 在各个worker之间安排资源
- Spark基于弹性分布式数据集RDD运作,加快数据的读写操作
Components of Spark
- Spark core: 大规模并行分布式数据处理的基座引擎, 负责内存管理,容错,在集群上调度/分发/监控作业,与储存系统互动
- Spark core内嵌了RDD, RDD是一个不可变的分布式的对象集合,不进行运算
- RDD经过Transformation变为新RDD/经过Action变为Output
- Spark SQL: 结构上分为三层, 从下到上:
- 数据源, 如CSV和JSON
- Data Source API: 将不同格式的数据统一格式并输出的接口
- Data Frame API: 在格式化的数据上进行filter/select/join等操作, 输出Data Frame
- Spark Streaming: 轻量级API能让开发者轻松的对数据进行批处理和实时流处理,每隔一段时间就将实时数据流切割成Batch,Spark将Batch当作RDD并使用RDD操作来处理
- Mlib: low level机器学习库,实现多种机器学习算法
- GraphX: Spark原生的图计算引擎与图数据存储
Spark Architecture and RDD
Spark Architecture
- Spark采用Master Slave架构,由一个运行在主节点的driver以及散布在集群的各工作节点上的executor组成
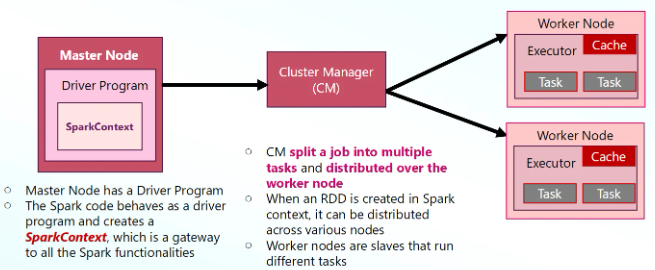
- Driver负责创建SparkContext,分配工作
- Cluster Manager根据SparkContext实际分配资源
- Executer进行Task计算,缓存数据并返回结果
Resilient Distributed Datasets(RDD)
- RDD是Spark中最基础的abstraction/object,表示一个不可变的,已分区的元素集合
- Lazy evaluation: 算子不会立即执行,而是在内存中构建一颗运算树,只有在需要结果的时候才会真正进行计算
- Data lineage: 记录得到结果所需的一系列数据操作
- Immutability: RDD不能被修改,只能定义一个新的RDD
Partitions
- 数据集如果整个处理的话可能无法装进内存, 使用行处理的话虽然灵活但是很可能比批处理慢
- 因此Spark用户可以定义一个partition(分区)
sc.parallelize(data, 1)   # 1 个分区
sc.parallelize(data, 2)   # 2 个分区
Create RDD
parallelize(): 将一个local python object分发出去构成一个RDDcollect(): 从RDD中取出值
# from a list
rdd_data = spark.parallelize([1,2,3])
rdd_data.collect()
#output:[1,2,3]
data = [(“A”, 1), (“B”, 2), (“A”, 3), (“B”, 5)]

def multipleTwoToTheValue(item):
    key, value = item
    return(key, value * 2)

def filterA(item):
    key, value = item
    return key == 'A'

spark = ss.context
rdd = spark.parallelize(data)    #创建rdd,transformation
double = rdd.map(multipleTwoToTheValue)    #将value*2,transformation
doubleA = double.filter(filterA)     #只保留key=A,transformation
doubleA.collect()    #收回结果,action
- 整体顺序遵循parallelize → map → filter → collect
- Narrow Transformation: 可以只靠一个partition算出来
- Wide Transformation: 需要靠多个partition才能算出来
Job, Stage and Task
- Spark code会被转换为一个或多个jobs,每个jobs由stage构成,而每个stage又包含若干task
- 按照每个action切割job / 按照有没有shuffle切割stage / 按照partition的数量切割task
Data lineage
- 转换过程的高阶轨迹(只记录操作不记录具体数据)作为逻辑计划的一部分被保存下来
- 如
csv → Filter → Aggregate
- 如果某个分区 partition 丢了,Spark 就用这条血缘,把那些转换重新施加一遍来重算数据。
== Optimized Logical Plan ==
Aggregate [movieID#875], [movieID#875, count(1) AS count#878L]
+- Project [movieID#875]
   +- Filter (isnotnull(rating#876) AND (cast(rating#876 as bigint) > 3))
      +- Relation [userID#874,movieID#875,rating#876] csv
Impact of Partition Size
- partition较大时: 启动task的开销更小,但是可能暴露不出足够的并行度,无法完全利用所有核心,占用更多内存
- partition较小时: 启动task的开销更大,但是并行度高,每块更小,内存占用低
Caching
- 有些RDD会被反复使用
- 与Dask中的
persist()类似,Spark也可以缓存中间结果
all_weather = …
hk_weather = all_weather.filter(…)
hk_weather.cache()    #存入缓存
...
hk_weather.unpersist()    #释放RDD
Join and Partition
partition: 把一个大数据集切成若干个小块join:将两张表按照相同的key进行配对拼成一张表(两张表必须位于同一个分区)
Fault Tolerance
- worker failure:
- 分配给这个worker的task会丢失
- Spark可以用RDD的lineage information重新计算丢失的分区
- Driver program会自动把这些任务改派给其他的可用工作节点
Driver failure:
- 会导致应用状态以及所用正在运行的job信息全部丢失
- 没有自动恢复机制,需要整个从头重启
链接